过去一年,站长们给网站加 AI,最常见的做法是接一个大模型接口:把内容喂进去,让它吐一段文字回来,再从这段文字里抠结论。这套流程能跑,但成本和延迟都不低。你明明只需要一个「是,或者否」,却按一次完整生成付了钱。
2026 年 10 月,一个新品类开始被反复提起——决策模型(Decision Model)。它不写文章、不聊天,只做一件事:读入文本或图片,直接给出选项的概率或打分。对资源站、论坛、企业官网这类每天要处理大量用户内容的站点来说,这可能是比「再接一个大模型」更划算的升级方向。
图片由 AI 生成
它和聊天模型到底差在哪
聊天模型的工作方式是「续写」:给一段话,它预测下一个词,一路生成下去。决策模型反过来,把输入压成一个判断,输出的是每个候选的分数,而不是一段自然语言。少了逐字生成这一步,推理开销和响应时间都会明显下降。
这个 10 月冒出来的几款产品,思路都很接近。vLLM 的 Semantic Router 发布了 Decision 3.0,一口气放了五个 Apache 2.0 许可的多模态决策模型,参数从 0.8B 到 27B;Nace AI 的 Drex 1.5 是 9B,能在一次前向计算里给每个选项都返回概率,支持 128K 上下文;Liquid AI 的 d1-3B 和 d1-omni-600M 主打端侧,连 600M 的版本都能读文本和小图。它们共同的关键词是「小」和「专」——不追求全能,只把判断做准。
网站能拿它做什么
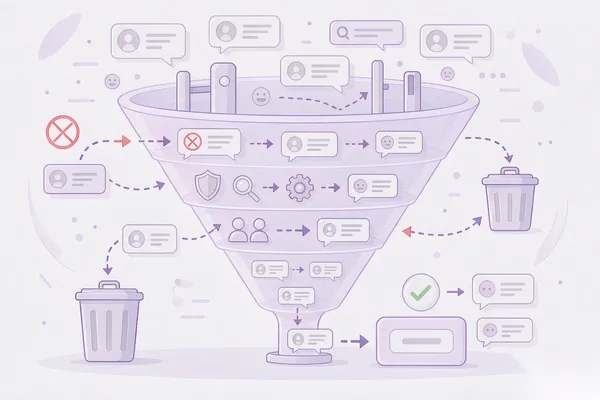
把「判断」这件事拆开看,一个内容型站点每天要做的判断其实很多,而且大多是重复的:
- 垃圾评论过滤:这条评论是正常讨论还是广告灌水?给一个「垃圾 / 正常」的二选一。
- 内容分类打标:一篇新投稿该进「源码」还是「教程」?在多分类里选一个最像的。
- 敏感与合规初筛:标题和摘要里有没有需要人工复核的风险词,先由模型标出来,再由人确认。
- 工单与问答路由:用户留言属于售前、售后还是技术问题,决定转给谁。
- 广告位与推荐位判断:这条内容适不适合放到首页推荐位。
这些场景有一个共同点:结论是离散的、有限的,不需要模型「解释」。用一个大模型去生成一段话再解析,等于绕了一圈;决策模型直接给分,链路更短,也更好接进现有的审核流程。
图片由 AI 生成
落地的三个现实问题
第一,别指望它什么都会
决策模型强在「在你定义好的几个选项里选」,弱在「开放式地理解一切」。所以用之前,要先把判断拆成明确的类别。比如评论审核,不要笼统地问「这条评论好不好」,而要拆成「是否包含链接」「是否包含联系方式」「是否与文章主题相关」几个独立的小判断,每个交给模型打分,再用人定的阈值组合。拆得越清楚,小模型越稳。
第二,阈值要靠自己的数据调
模型给的是概率,不是结论。0 到 1 之间那条线画在哪里,决定了你是「漏放广告」还是「误杀正常用户」。稳妥的做法是先把历史评论、历史投稿捞出来做一批样本,人工标一遍,再看模型在你关心的那类错误上表现如何,最后定阈值。别直接照搬别人博客里的数字。
第三,先算清楚值不值得自建
决策模型的卖点是便宜和快,但「便宜」是相对的。如果你的站每天只有几十条评论,接一个大模型接口按量付费,可能比专门部署一个模型、维护一台机器更省事。反过来,日处理量上千、又对延迟敏感的场景,自建一个小决策模型才开始显出优势。
| 判断场景 | 建议做法 |
|---|---|
| 日评论量几十条 | 先用现成大模型接口,人工兜底 |
| 日评论量上千、需实时 | 自建小决策模型,配阈值规则 |
| 多分类打标 | 先用嵌入模型算相似度,再人工抽检 |
| 合规初筛 | 模型只做提示,最终由人确认 |
一个务实的上手顺序
如果你真想试,别一上来就替换现有流程。先挑一个「错了也不致命」的环节,比如给新投稿做初步分类,或者给评论打一个「疑似广告」的标记,让它在后台跑一段时间,和人工结果对照。等准确率稳定了,再逐步把它放到更靠前的位置。决策模型的价值不在于多聪明,而在于把大量重复判断的成本压到很低——前提是你愿意先花时间把问题拆清楚、把阈值调对。
这一轮小模型竞赛才刚开始,参数会越做越小,许可会越放越开。对站长来说,真正要练的不是追新,而是把「哪些判断可以交给机器、哪些必须留给人」这件事想明白。
相关阅读
2025 年最值得上手的 10 个 AI 开源项目:从本地跑模型到搭出自己的智能体
Agent Skills 进了 Linux 基金会:把网站日常运维写成能复用的技能文件