搭建本地知识库问答:主流开源 RAG 平台怎么挑
把公司文档、产品手册、技术资料变成「能问答的知识库」,是目前 AI 落地里最常见也最实用的场景之一。而 RAG(检索增强生成)正是实现这件事的主流技术路线。市面上的开源 RAG 平台已经不少,各有侧重,选对了能省下大量重复开发。
图片由 AI 生成
RAG 到底在做什么
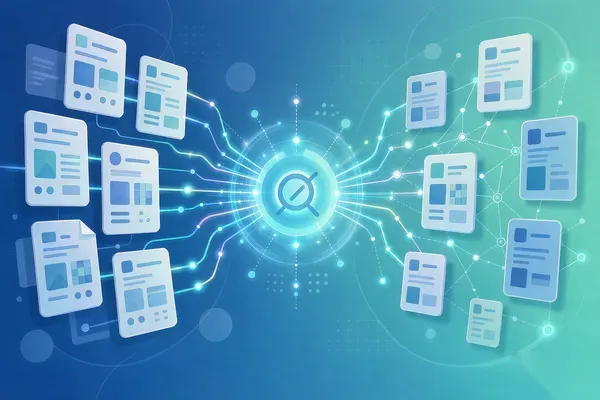
说白了就三步:把你的文档切块、存进向量库;用户提问时,先检索出最相关的几段内容;再把这几段内容连同问题一起交给大模型,让它基于这些材料回答。这样能有效缓解大模型「胡说八道」和「不知道你私有资料」的问题。
听起来简单,但实际做起来坑很多——文档怎么切、切多大、检索用什么策略、怎么处理表格和图片,每一环都影响最终效果。
看重流程编排:Dify 这类
有一类平台的核心卖点是可视化的工作流编排。你可以在界面上拖拽节点,把检索、模型调用、条件判断、格式输出这些步骤连成一条流程。对于要快速搭出可用应用、又不想写太多代码的团队,效率很高。
这类平台通常也自带知识库管理、模型接入、应用发布等一整套功能,适合从零开始做一个对外服务的场景。
图片由 AI 生成
看重文档解析深度:RAGFlow 这类
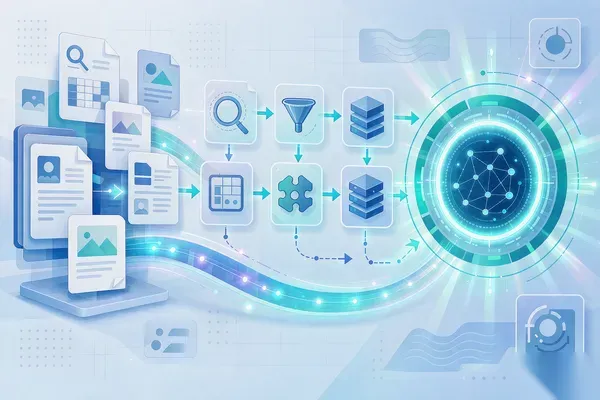
另一类平台把重心放在「文档理解」上。现实里的企业文档五花八门,有扫描件、有复杂表格、有多栏排版的 PDF,普通切分方式会把内容切得支离破碎。这类平台在版式解析上下更多功夫,能更好地还原文档结构,对专业资料库的效果提升明显。
如果你的数据源主要是排版复杂的 PDF 和扫描件,这类平台的优势会很直观。
看重轻量部署:AnythingLLM 这类
如果需求不复杂,就是要一个能装、能跑、能对内使用的问答工具,那轻量平台更合适。它们部署简单,资源占用低,甚至能跑在普通电脑上,配上本地模型就能实现完全离线。
适合个人、小团队,或者对数据保密要求极高、连云端接口都不想用的场景。
看重企业级功能:MaxKB 这类
国内一些平台在企业级功能上做得比较完整,比如权限管理、多用户、审计、和现有系统的对接等。对于要在公司内部大规模推广的场景,这些「非 AI 能力」往往比模型效果更能决定项目能不能落地。
选型建议
先明确一件事:你的瓶颈在「文档质量」还是在「流程复杂度」?文档乱、格式复杂,优先选解析能力强的;流程绕、要串很多系统,优先选编排能力强的;只是想快速有个能用的问答,选轻量的。
还有一点容易忽略:RAG 的效果提升,往往来自数据处理这一端,而不是换一个更强的模型。花时间把文档清洗干净、把切分策略调好,收益通常比换模型大得多。