MoE 架构是什么:为什么 5000 亿参数的模型只激活 23 亿
2026 年 10 月,Reflection AI 发布的 Beam 模型让很多人困惑:它号称总参数 5010 亿,但每处理一个 token 只激活 230 亿参数,不到总量的 5%。剩下的 95% 在做什么?这不是宣传口号,而是 MoE 架构的正常工作方式。理解这个概念,对判断一个模型的实际成本很有帮助。
图片由 AI 生成
先看传统模型的问题
我们平时说的「稠密模型」,可以想象成一位经验丰富的全科医生。优点是每个病人都得到同一个大脑的认真对待,缺点是——你只是来看个感冒,也要动用他几十年的全部医学积累。也就是说,无论问题简单还是复杂,模型都要跑完全部参数,计算量固定且巨大。
模型的参数量越大,这个「全科医生」越博学,但每次问诊的成本也越高。这就是为什么稠密模型想做大,成本会迅速失控。
图片由 AI 生成
MoE 的思路:换成一家大医院
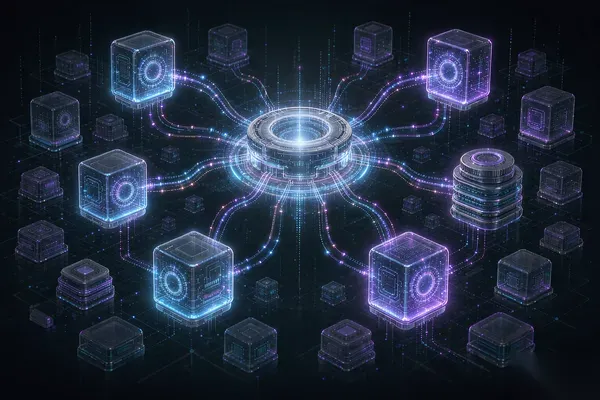
MoE 的全称是 Mixture of Experts,混合专家。它的做法是把一个全科医生,改成一家大医院:不再是一个大脑处理所有问题,而是分成几十上百个专科——数学科、代码科、古典诗词科等等,再配一个「前台分诊员」,业内叫路由器。
来了一个 token,分诊员看一眼内容,判断它属于哪类问题,然后只把「数学科」和「代码科」的专家叫出来,其他人继续休息。于是这一次推理,只有少数几个专家真正参与计算,其余专家完全不动。
这就是「5010 亿参数只激活 230 亿」不矛盾的原因:总参数是医院的规模,激活参数是这次问诊真正上班的人数。
为什么大家都转向 MoE
MoE 的好处是显式的:能力规模可以做得很大,但单次计算成本保持在较低水平。这意味着在同样的硬件条件下,你能跑一个「知识储备」更厚实的模型,或者用同样的模型成本换更高的吞吐。
这也解释了为什么 2026 年这批新模型普遍采用稀疏 MoE。Mistral Large 4 总参数约 1 万亿,每次激活约 520 亿;Kolibri 总参数 780 亿,激活约 34.6 亿;Beam 总参数 5010 亿,激活 230 亿。它们的设计哲学是一致的——把参数堆上去,但把每次干活的成本压下来。
MoE 也不是没有代价
第一,总参数决定了显存需求。即使每次只激活一小部分专家,模型权重还是要全部加载到显存里,所以大 MoE 模型对硬件的要求并不低。
第二,路由器的判断质量很关键。如果分诊员把问题分错了科室,效果会明显下降。训练一个靠谱的路由器本身也是难点。
第三,MoE 的微调比稠密模型更复杂,需要额外注意专家之间的负载均衡问题,否则容易出现部分专家被过度使用、部分专家几乎闲置的情况。
对使用者的实际影响
理解 MoE 之后,有两个认知需要修正。
其一,不要用「参数量」直接判断模型的能力和成本。两个总参数相同的模型,如果激活参数差很多,实际的推理速度和部署成本可能相差悬殊。看模型时,激活参数往往比总参数更有参考价值。
其二,部署 MoE 模型时,显存预算要按总参数来算,不能按激活参数算。很多人被「只激活 23 亿」误导,以为小显卡就能跑,结果加载模型时直接显存溢出。
总的来说,MoE 是目前在「能力上限」和「计算成本」之间找平衡的主流方案。理解了它的取舍,你在选模型和做部署规划时就能少走很多弯路。